Cargas automáticas y un almacén común que sostienen todo el análisis posterior.
Los informes suelen fallar por debajo: exportaciones a mano, ficheros que cambian de formato sin avisar y ningún lugar donde los datos de los distintos sistemas convivan. La ingeniería de datos construye esa capa intermedia, con cargas programadas, un modelo común y control de lo que entra.
Casi todos los problemas tecnológicos son problemas de negocio con otro nombre.
Por eso trabajamos la estrategia antes que el código, y medimos cada entrega por la cifra que mueve.
50+
Proyectos entregados
40+
Empresas que han confiado en nosotros
8
Casos publicados
2023
Año de inicio en Barcelona
Qué incluye.
Esta es la parte del trabajo que no aparece en ninguna demostración y de la que depende todo lo demás. Se construye una vez y con la intención de añadir después orígenes y preguntas nuevas sin volver a empezar.
Inventario de orígenes y vía de acceso
Cada origen se estudia antes de escribir código: el ERP y las formas en que permite leerse, las aplicaciones con API, los Excel que actúan como maestro y las carpetas de SharePoint. Sustituir un envío manual de ficheros por una consulta SQL a través de red privada es, con frecuencia, la primera decisión que quita trabajo.
Procesos de carga en Python
La extracción y la transformación se escriben en Python, un módulo por origen y con la lógica de negocio separada de la conexión. Se ejecutan de madrugada para que los datos del día anterior estén disponibles al empezar la jornada, como en Grupo Pomona Iberia con las cuatro empresas del grupo.
Almacén con un modelo común
El destino es un almacén en SQL Server, PostgreSQL o MySQL con un modelo en estrella que sitúa empresas, catálogos y sistemas bajo el mismo lenguaje: los hechos por un lado, las dimensiones compartidas por otro. Es lo que permite comparar unidades que nunca usaron los mismos códigos.
Orquestación, reintentos y avisos
Cuando hay varias cargas con dependencias entre ellas, la secuencia se orquesta con Apache Airflow sobre Docker: qué se ejecuta antes que qué, cuántos reintentos caben y a quién se avisa cuando algo falla. Para un único proceso nocturno basta una programación simple, y así se plantea en lugar de montar infraestructura de más.
Calidad del dato y control de lo que entra
Cada carga valida lo que recibe: tipos, duplicados, registros sin referencia y variaciones imposibles respecto al día anterior. Lo que no pasa la validación se aparta y se registra en lugar de contaminar el modelo, y queda un histórico de ejecuciones con qué entró, qué se rechazó y por qué.
Entrega a las herramientas de análisis
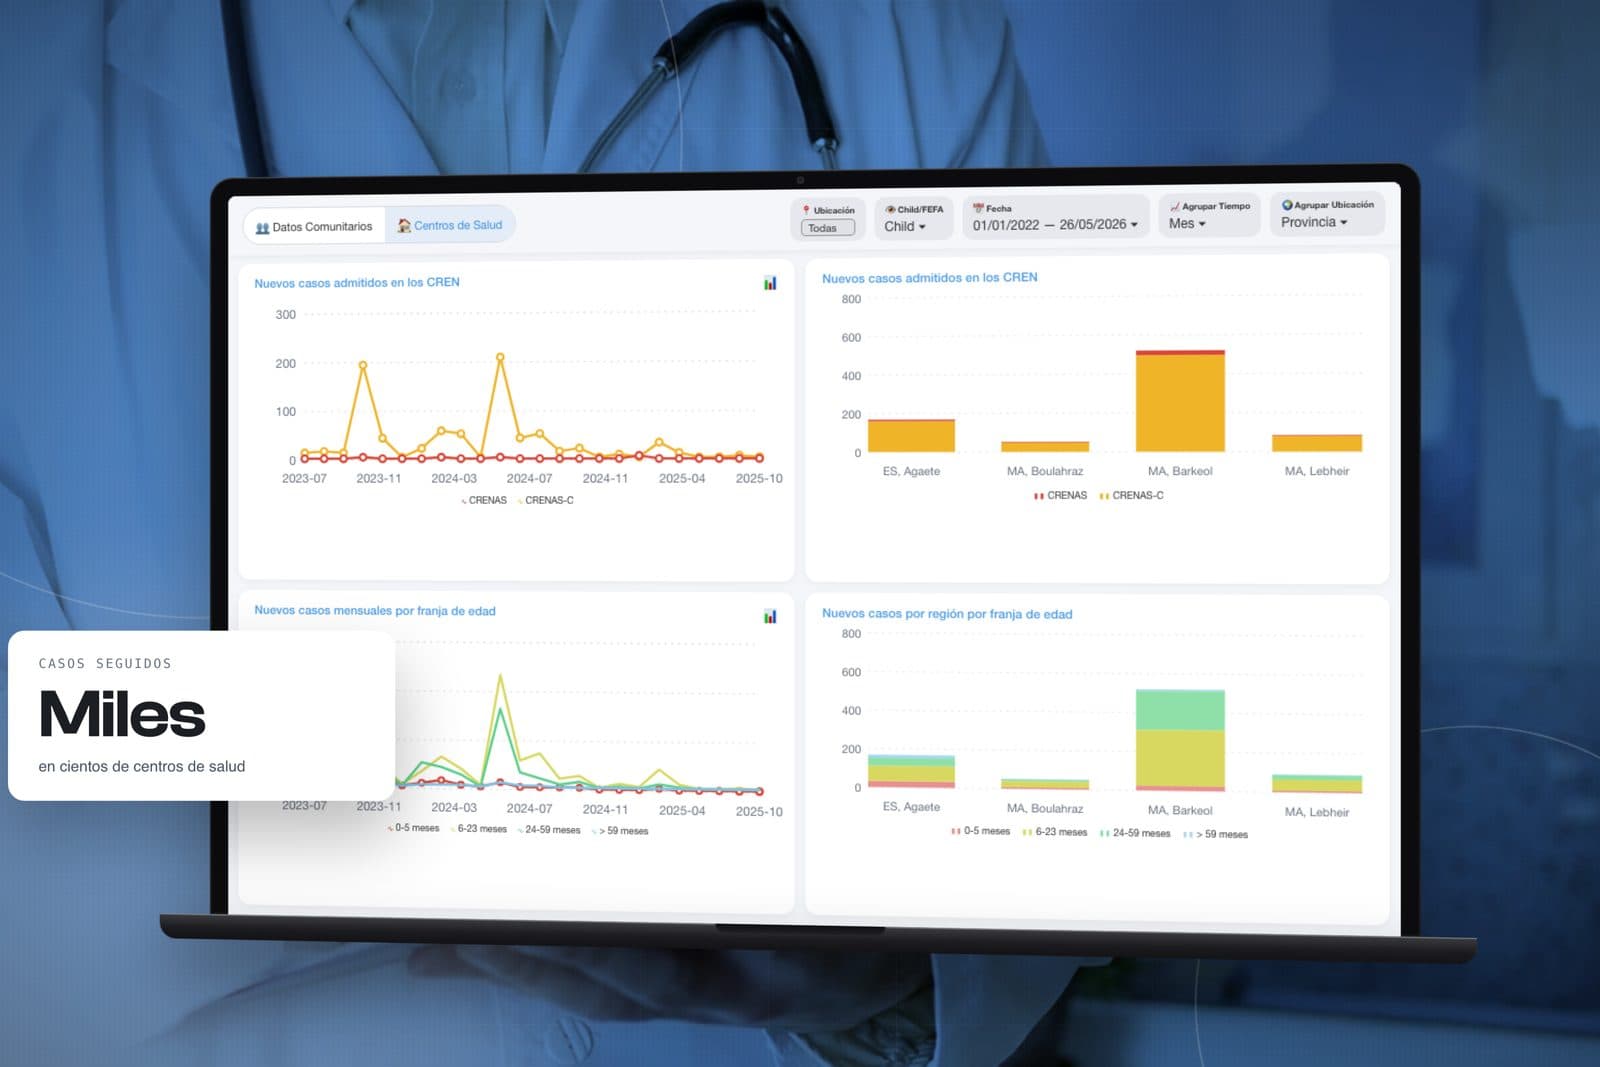
El almacén se expone a quien lo consume, ya sea por conexión directa desde Power BI o mediante una API REST con autenticación cuando hay aplicaciones y cuadros de mando propios de por medio, como en la plataforma de Nut4Health. La capa de análisis deja así de depender de la estructura interna del almacén.
Cómo trabajamos.
01
Analizamos
Una primera sesión para entender el proceso, los sistemas que ya están en marcha y lo que hoy cuesta tiempo o dinero. De ahí sale un diagnóstico escrito, no una presentación de intenciones.
02
Decidimos y presupuestamos
Con el diagnóstico delante se decide qué se construye, qué se integra y qué es mejor no tocar. La propuesta llega con alcance, plazo y precio cerrados antes de empezar.
03
Construimos y lo dejamos en producción
El trabajo se entrega por partes utilizables, con pruebas en cada cambio. Al final queda en producción, documentado y con el equipo formado para usarlo sin depender de nosotros.
¿Cuándo hace falta un almacén y cuándo basta con conectar el informe al origen?
Con un origen limpio y poco volumen, conectar directamente es más simple y se sostiene durante años. El almacén se justifica cuando hay que cruzar sistemas que no comparten códigos, cuando el histórico ya no se puede recalcular en cada consulta o cuando el origen no aguanta las consultas de análisis sin afectar a la operación diaria.
¿Cómo se presupuesta?
Por número de orígenes y por la dificultad de acceso a cada uno, que es lo que mueve de verdad el esfuerzo. El precio se cierra en la propuesta, con la primera carga en producción como primer hito. La infraestructura en Azure o AWS se contrata a nombre de la empresa y su coste mensual se estima antes de empezar.
¿Cuánto tarda la primera carga en funcionar?
Semanas y no trimestres, y lo que marca el plazo suele ser conseguir accesos: una VPN, un usuario de solo lectura en el ERP, permisos en SharePoint. Por eso el proyecto empieza por un origen completo de punta a punta, en producción, antes de añadir los demás.
¿Qué ocurre cuando un origen cambia o se sustituye el ERP?
Los procesos están separados por origen precisamente para eso: se reescribe el módulo afectado, el modelo común no se toca y los informes siguen funcionando igual. Un cambio de ERP supone una carga nueva y una temporada conviviendo con las dos fuentes, no un proyecto desde cero. El código y el almacén son de la empresa, de modo que otro equipo puede continuarlos.
Nuestro stack
De los ERPs a la infraestructura cloud, elegimos herramientas que reducen el riesgo, encajan con los sistemas existentes y duran. Con ellas entregamos rápido y mantenemos en producción lo entregado.
“Estamos trabajando con Guille y Leo y la verdad es que estamos muy contentos con el resultado. Son profesionales, cumplen con los plazos y nos lo ponen todo muy fácil. Gente así cuesta de encontrar”
“No me cansaré de recomendarlos.
Con Leo y Guille desarrollamos conjuntamente un proceso de automatización para la gestión, estructuración y visualización de datos acumulados durante años de trabajo de campo en tres distritos distintos de Barcelona. Se trataba de un conjunto de información muy extenso y heterogéneo, y…”
“Trabajar con Laketab nos ha permitido dar un salto claro en cómo gestionamos la información. Hemos pasado de procesos manuales a un reporting automatizado, fiable y completamente alineado con nuestra realidad de negocio. No sólo han desarrollado la solución, sino que ha entendido la lógica financiera y operativa…”